
Ein einzelner KI-Agent löst innerhalb von Sekunden dutzende Modellaufrufe aus. Ein veränderter Prompt, ein neues Feature, eine automatisierte Pipeline, die auf ein unerwartetes Event reagiert: Die Kostenstruktur sieht plötzlich anders aus, noch bevor das erste Dashboard aktualisiert wurde.
Unternehmen integrieren KI immer tiefer in ihre Produkte, internen Tools und Automatisierungen. Was dabei oft unterschätzt wird: KI verändert nicht nur die Software selbst, sondern auch, wie Kosten entstehen und abgerechnet werden. Klassische Cloud-Workloads wachsen relativ vorhersehbar. KI-Systeme nicht.
Das strukturelle Problem: Sichtbarkeit kommt nach der Entscheidung
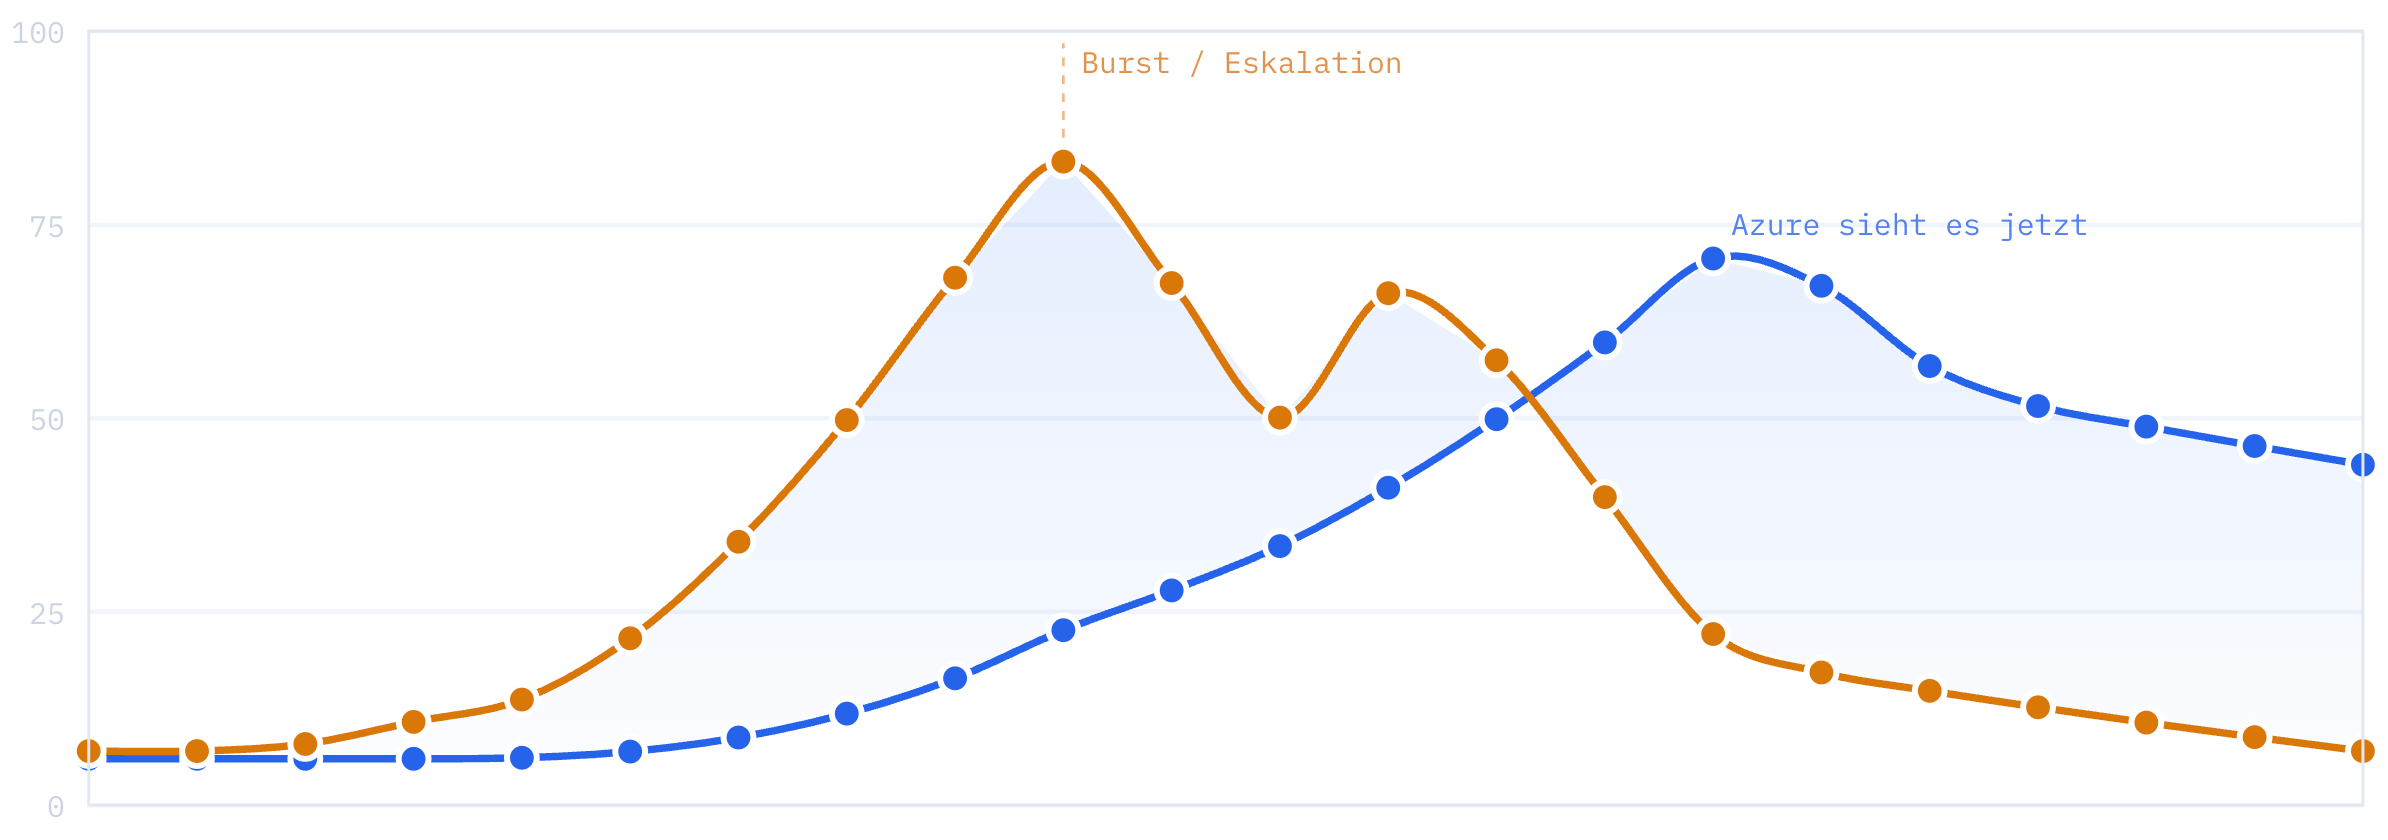
Das Kostenmanagement der Cloud Provider, etwa Azure Cost Management, liefert korrekte Zahlen, aber mit einer Verzögerung, die für KI-Workloads kritisch ist. Microsoft selbst weist darauf hin: Kosten- und Usage-Daten erscheinen je nach Vertragstyp typischerweise 8 bis 24 Stunden verzögert, bei Pay-as-you-go bis zu 72 Stunden.
Für virtuelle Maschinen, Storage oder klassische Infrastruktur war das lange akzeptabel. Für KI-Workloads verändert es die Risikodynamik fundamental:
- Sprunghafte Nutzung: Token-Verbrauch entsteht nicht linear, sondern in Bursts. Ein einzelner KI-Agent kann Folgeprozesse und weitere Agenten auslösen, die jeweils eigene Modellaufrufe starten.
- Geschwindigkeit vor Transparenz: Budgetspitzen entstehen in Minuten. Die Sichtbarkeit darüber kommt Stunden oder Tage später.
- Dezentrale Ausführung: Verschiedene Teams, Modelle und Agenten laufen parallel, ohne gemeinsame Kostensicht in Echtzeit.
Das eigentliche Risiko ist nicht die Höhe einzelner Kosten. Es ist die Geschwindigkeit, mit der sie entstehen, kombiniert mit einer Governance-Struktur, die erst nach der Tatsache eingreift.
Reaktive Governance basiert auf der Annahme, dass Nutzung vorhersehbar genug ist, um sie nachträglich zu steuern. Bei klassischer Cloud-Infrastruktur war das vertretbar. Kosten wuchsen linear, Anomalien fielen im Tagesreport auf, Korrekturen konnten greifen, bevor der Schaden groß wurde.
KI-Workloads folgen einer anderen Logik. KI-Agenten treffen eigenständig Entscheidungen, rufen weitere Agenten auf, starten Toolchains und lösen Folgeprozesse aus, die kein Team vorher geplant hat. Nutzung entsteht nicht linear, sie entsteht als Kettenreaktion. Und in genau diesen Momenten versagt ein Governance-Modell, das auf Vorhersehbarkeit ausgelegt ist. Token sind verbraucht, Aufrufe sind erfolgt, Budgets sind überschritten. Was dann noch möglich ist, ist keine Steuerung mehr. Es ist Schadensanalyse.
FinOps für KI ist ein Problem der Architektur, kein Reporting-Problem
FinOps (Financial Operations) beschreibt die Disziplin, Cloud-Kosten operativ zu steuern, nicht nur nachträglich zu reporten. Viele Organisationen versuchen, KI-Kosten mit denselben Tools zu managen, die für klassische Cloud-Infrastruktur gebaut wurden. Das funktioniert für die nachträgliche Abrechnung. Für operative Steuerung moderner KI-Systeme reicht es nicht.
FinOps verschiebt sich dadurch grundlegend: Kosten sind nicht mehr nur ein Ergebnis am Ende eines Prozesses, sondern ein Signal während der Ausführung. Wer KI verantwortungsvoll skalieren will, braucht eine Governance-Schicht, die dort greift, wo Nutzung entsteht, nicht erst im nächsten Tagesreport.
Token Control: Governance näher an die Ausführung bringen
Der Ansatz von Token Control besteht darin, die Lücke zwischen Ausführung und Abrechnung technisch zu schließen. Nicht durch bessere Reports, sondern durch eine zusätzliche Steuerungsebene direkt im Request-Flow.
Konkret bedeutet das:
- Echtzeit-Zuordnung: Jeder Modellaufruf wird im Moment der Ausführung einem klaren Kontext zugeordnet: Benutzer, Organisationseinheit, API-Key, Modell, Workflow. Keine nachträgliche Zuordnung, kein Raten beim Monatsabschluss.
- Präventive Budgets: Budgetgrenzen werden nicht nur überwacht, sondern vor dem Request geprüft. Eine Anfrage, die ein definiertes Limit überschreiten würde, wird gestoppt, bevor Kosten entstehen.
- Rollenbasierte Zugriffskontrolle: Welche Teams dürfen welche Modelle nutzen? Welche Agenten haben Zugriff auf kostenintensive Modelle? Diese Entscheidungen werden in der Plattformlogik getroffen, nicht nachträglich in Abrechnungstabellen rekonstruiert.
- Auditierbare Metadaten: Jeder Aufruf hinterlässt strukturierte Cost-Metadaten: für interne Verrechnung, Compliance-Anforderungen und nachvollziehbare Budgetverantwortung auf Abteilungsebene.
Kostenkontrolle muss dort erfolgen, wo Kosten entstehen
KI verschärft kein bestehendes Kostenproblem, sie verändert dessen Natur. Kosten entstehen schneller, verteilter und dynamischer als in klassischen Cloud-Modellen. Genau deshalb reicht es nicht mehr aus, Ausgaben nur im Nachhinein sichtbar zu machen.
Wer KI skalieren will, muss Kostenkontrolle näher an die Ausführung bringen. Nicht als spätere Auswertung, sondern als operative Fähigkeit im laufenden System. Erst wenn Governance dort greift, wo Requests entstehen, wird aus nachträglicher Kostensicht echte Steuerung.