Microsoft Foundry Agents mit Token Control unter Kontrolle
Inhalt
- Warum Regeln unterhalb der Modellauswahl liegen müssen
- Prompt Agents über ein admin-connected Modell
- Kontrollebene als Code statt als Klick
- Hosted Agents und eigene Agents
- Was Sie damit steuern
- Ihr nächster Schritt
Microsoft Foundry hat die Einstiegshürde für KI-Agenten so weit gesenkt, dass Agenten heute nicht mehr nur in Entwicklungsteams entstehen. Prompt Agents sind deklarative Agenten: Modell, Instructions und Tools werden beschrieben, nicht programmiert. Das ist die Geschwindigkeit, die Fachbereiche brauchen, und einer der Gründe, warum wir Foundry in Kundenprojekten regelmäßig empfehlen.
Bei einer selbst entwickelten Anwendung ist die Antwort auf Governance und FinOps einfach, denn der Endpunkt steht im Code. Bei einem deklarativ beschriebenen Agenten gibt es keinen Code. Für ihn gelten dennoch dieselben Budgets, dieselben Limits und dieselbe Nachweispflicht wie für jede andere KI-Lösung im Unternehmen.
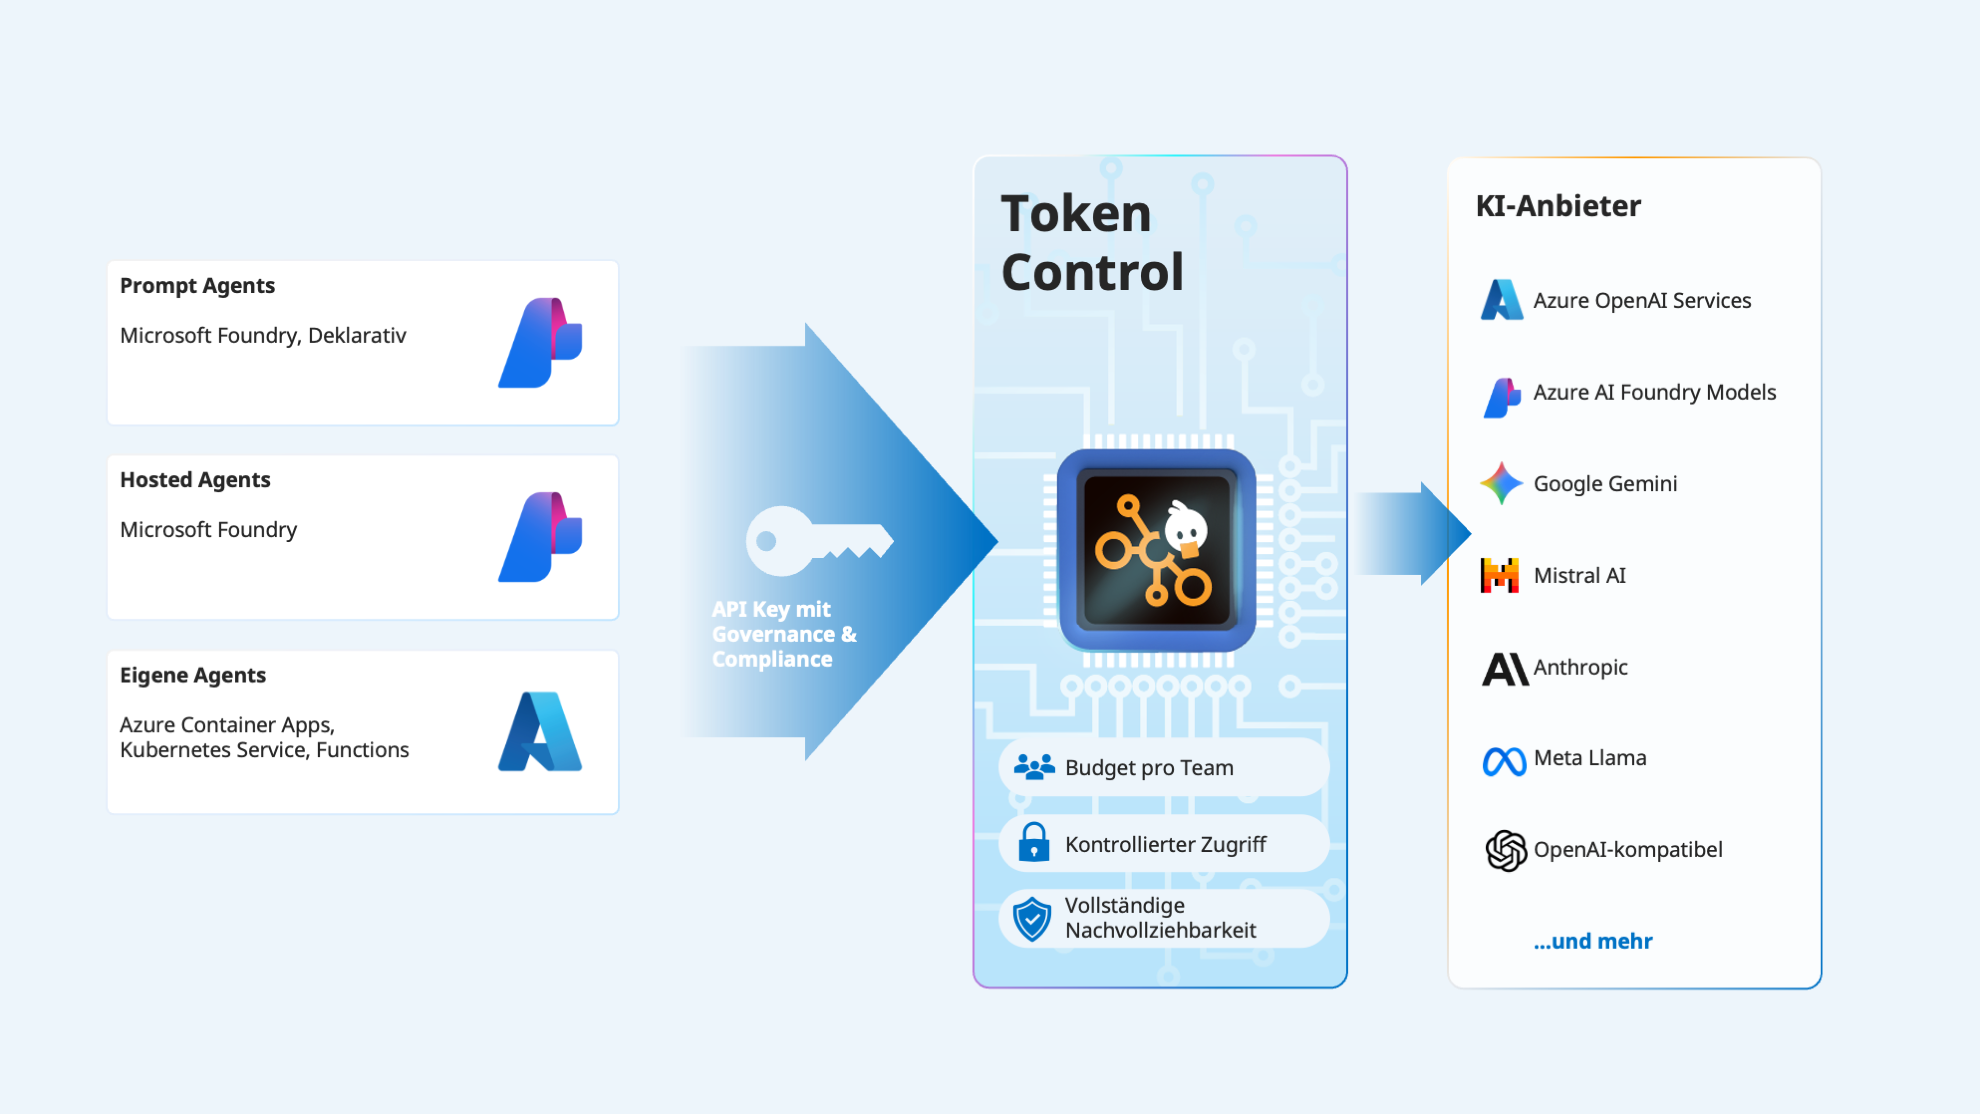
Token Control ist eine KI-Kontrollebene zwischen Ihren Anwendungen und Ihren Modellen, in der Budgets, Zugriffsregeln und Nachweise zusammenlaufen. In diesem Beitrag zeigen wir, wie Sie damit alle Agenten in Microsoft Foundry steuern, unabhängig davon, ob sie deklarativ beschrieben oder selbst entwickelt sind.
Warum Regeln unterhalb der Modellauswahl liegen müssen
Wenn Teams ihre KI-Nutzung ordnen wollen, nennen sie fast immer dieselben fünf Anforderungen: zuverlässiger Modellzugriff, Kostentransparenz in Echtzeit, feste Budgetgrenzen, Zuordnung pro Entität und eine Integration, die bestehende Lösungen nicht anfasst.
Mit Agenten werden diese Anforderungen dringlicher. Eine klassische KI-Funktion verbraucht Token pro Nutzeranfrage. Ein Agent verbraucht Token pro Arbeitsschritt, und wie viele Schritte ein Auftrag benötigt, entscheidet der Agent zur Laufzeit. Aus einer planbaren Kostenposition wird eine variable, und eine variable Position braucht eine Grenze, die vor dem Aufruf greift.
Entscheidend ist, an welcher Stelle diese Grenze sitzt. Wer einen Agenten deklarativ beschreibt, wählt ein Modell aus einer Liste und formuliert Instructions. Es gibt keine Anwendungskonfiguration, in die ein Plattformteam einen Endpunkt eintragen könnte, und keinen Build-Prozess, in den sich eine Richtlinie einhängen ließe. Die Regeln müssen deshalb unterhalb der Modellauswahl liegen, damit sie den Agenten erreichen.
Derselbe Maßstab gilt regulatorisch. EU AI Act und DSGVO fragen nicht danach, ob ein Agent entwickelt oder konfiguriert wurde. Sie fragen, wer ihn genutzt hat, mit welchem Modell, in welcher Region und mit welchem Ergebnis. Diese Auskunft muss aus der Plattform kommen, nicht aus dem einzelnen Agenten.
Prompt Agents über ein admin-connected Modell
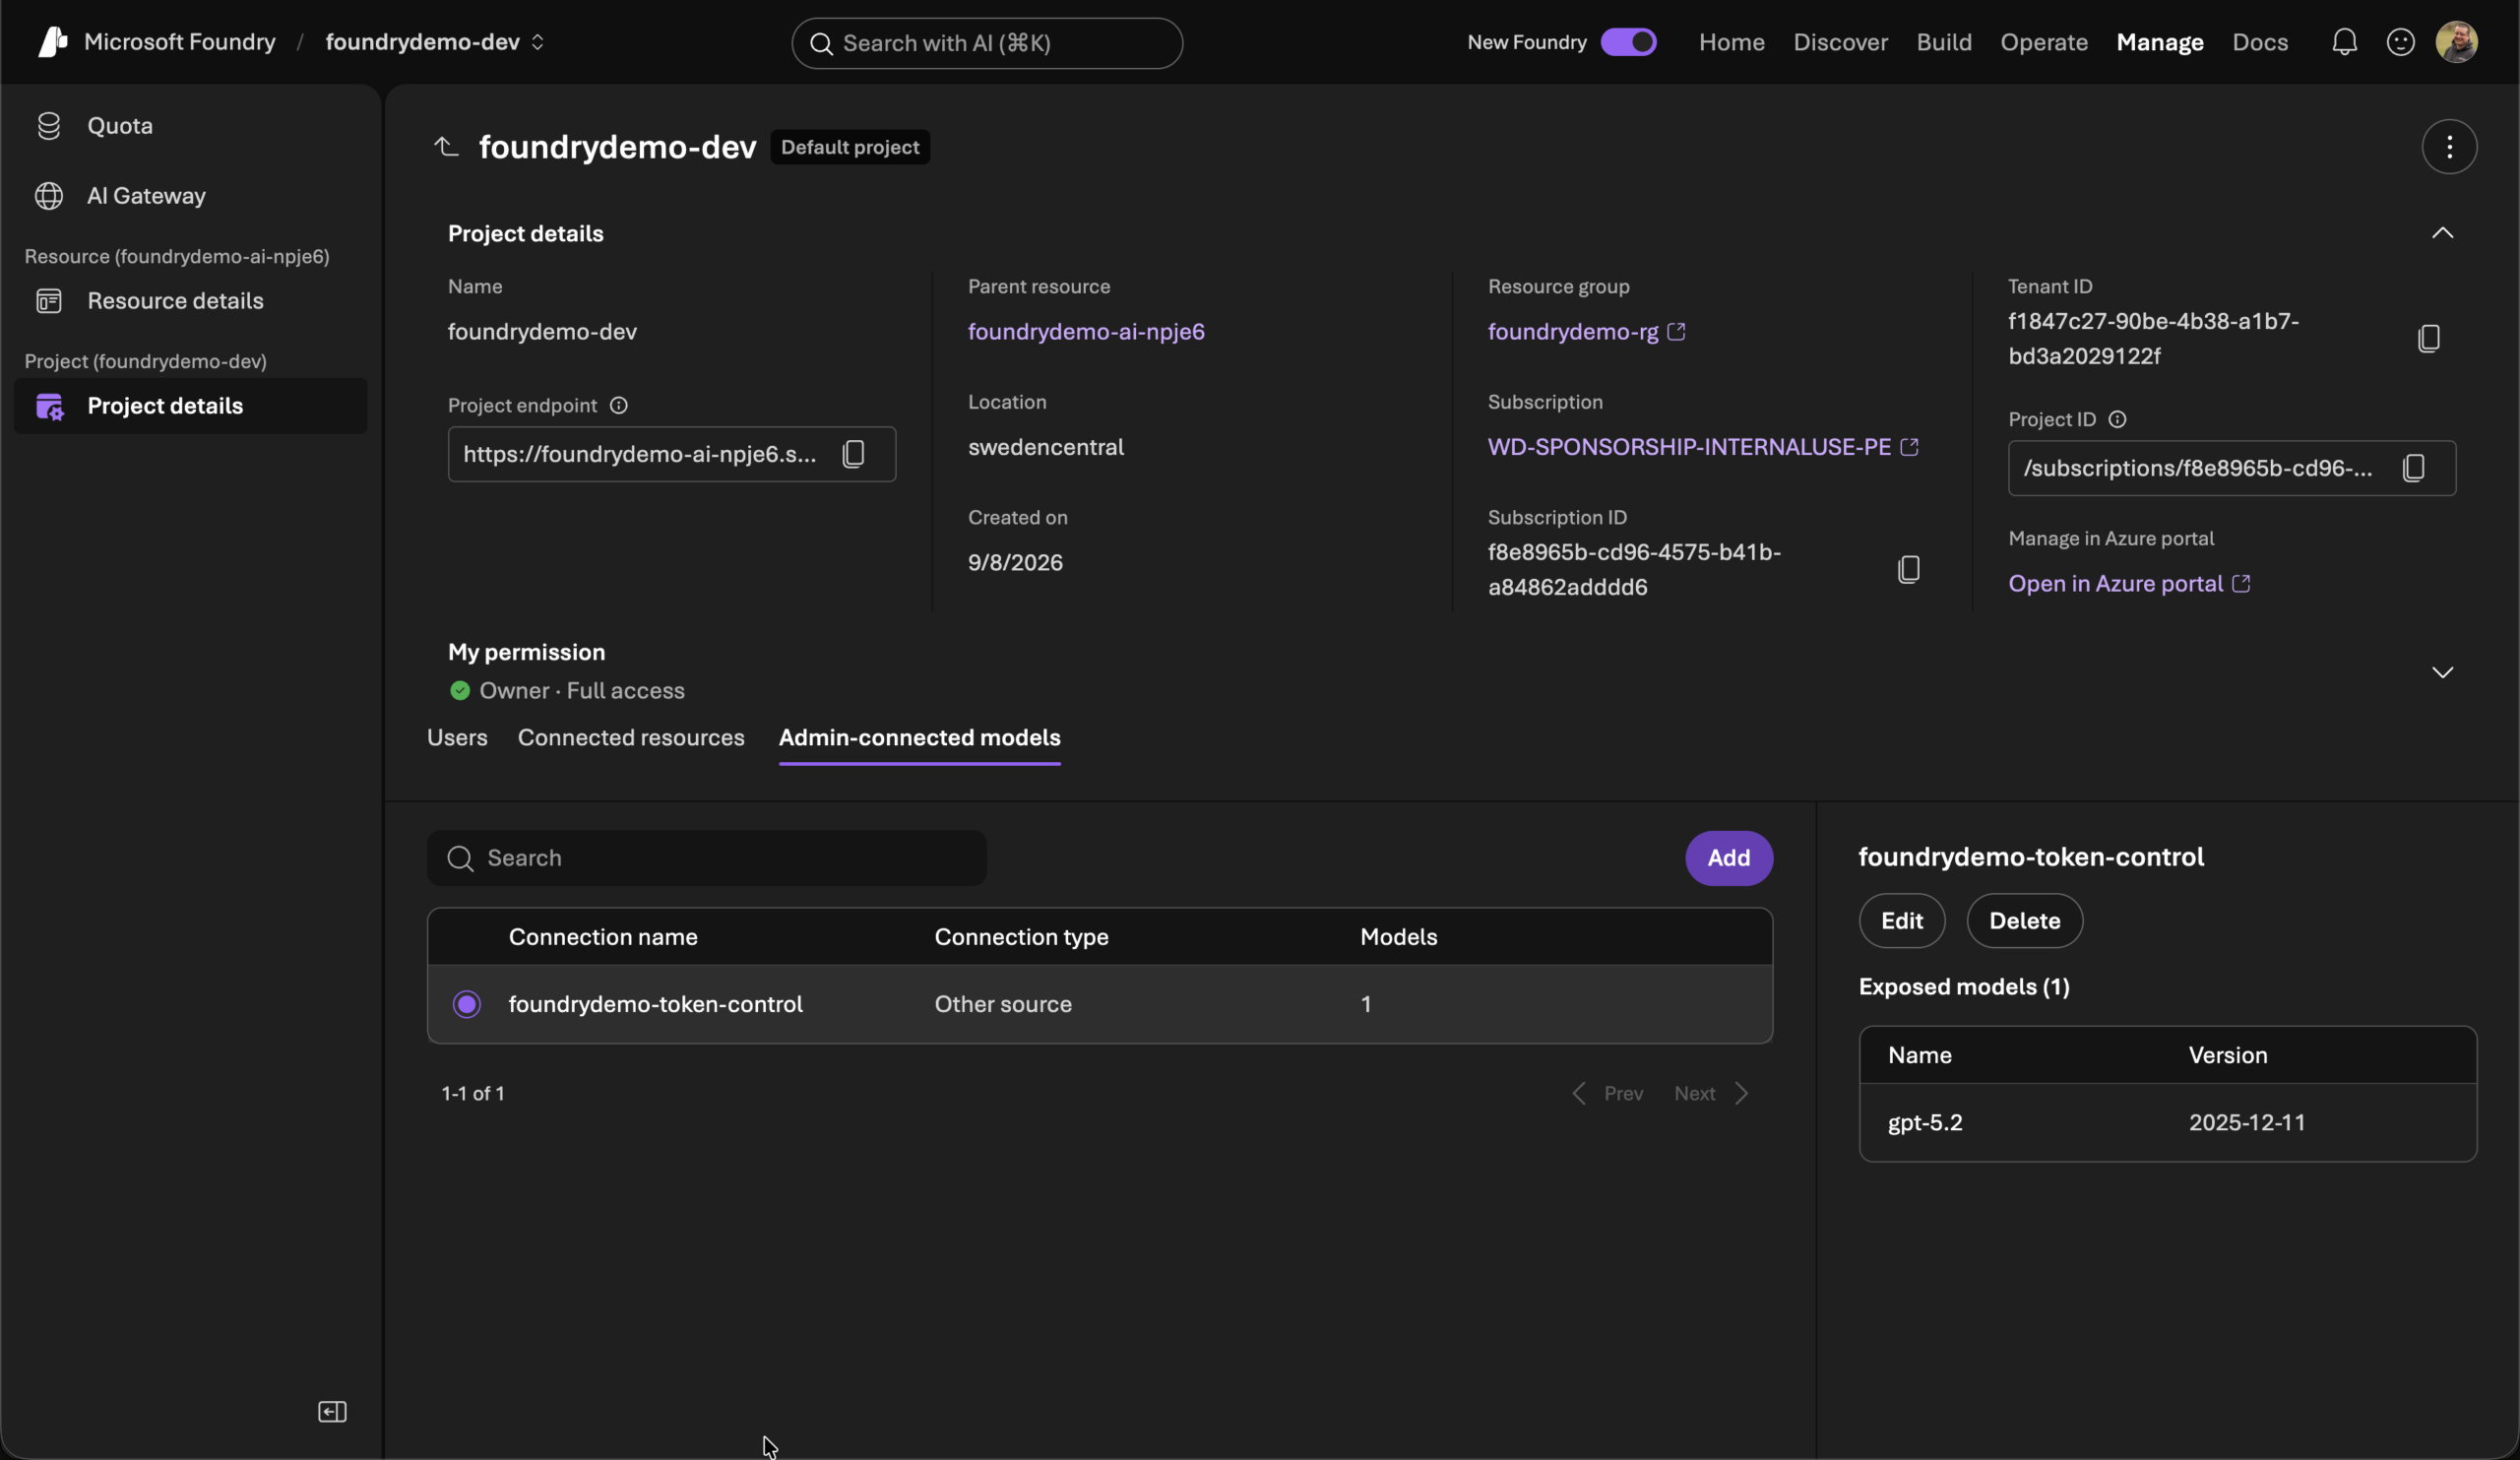
Microsoft Foundry erlaubt es, ein eigenes Modell-Gateway als Connection zu registrieren. Das Ergebnis heißt bei Microsoft admin-connected model und wird im Foundry Portal angelegt.
Hinterlegt werden dabei zwei Dinge: der Endpunkt von Token Control als Ziel der Connection und der zugehörige API-Key. Foundry ruft den Endpunkt anschließend selbst auf und ergänzt den Pfad der Chat Completions, sodass nur der Basispfad eingetragen wird. Die Modelle, die über diese Connection nutzbar sein sollen, werden dabei explizit benannt.
Das registrierte Modell erscheint anschließend als Deployment im Modell-Picker jedes Agenten im Projekt, adressiert als <connection-name>/<model-name>.
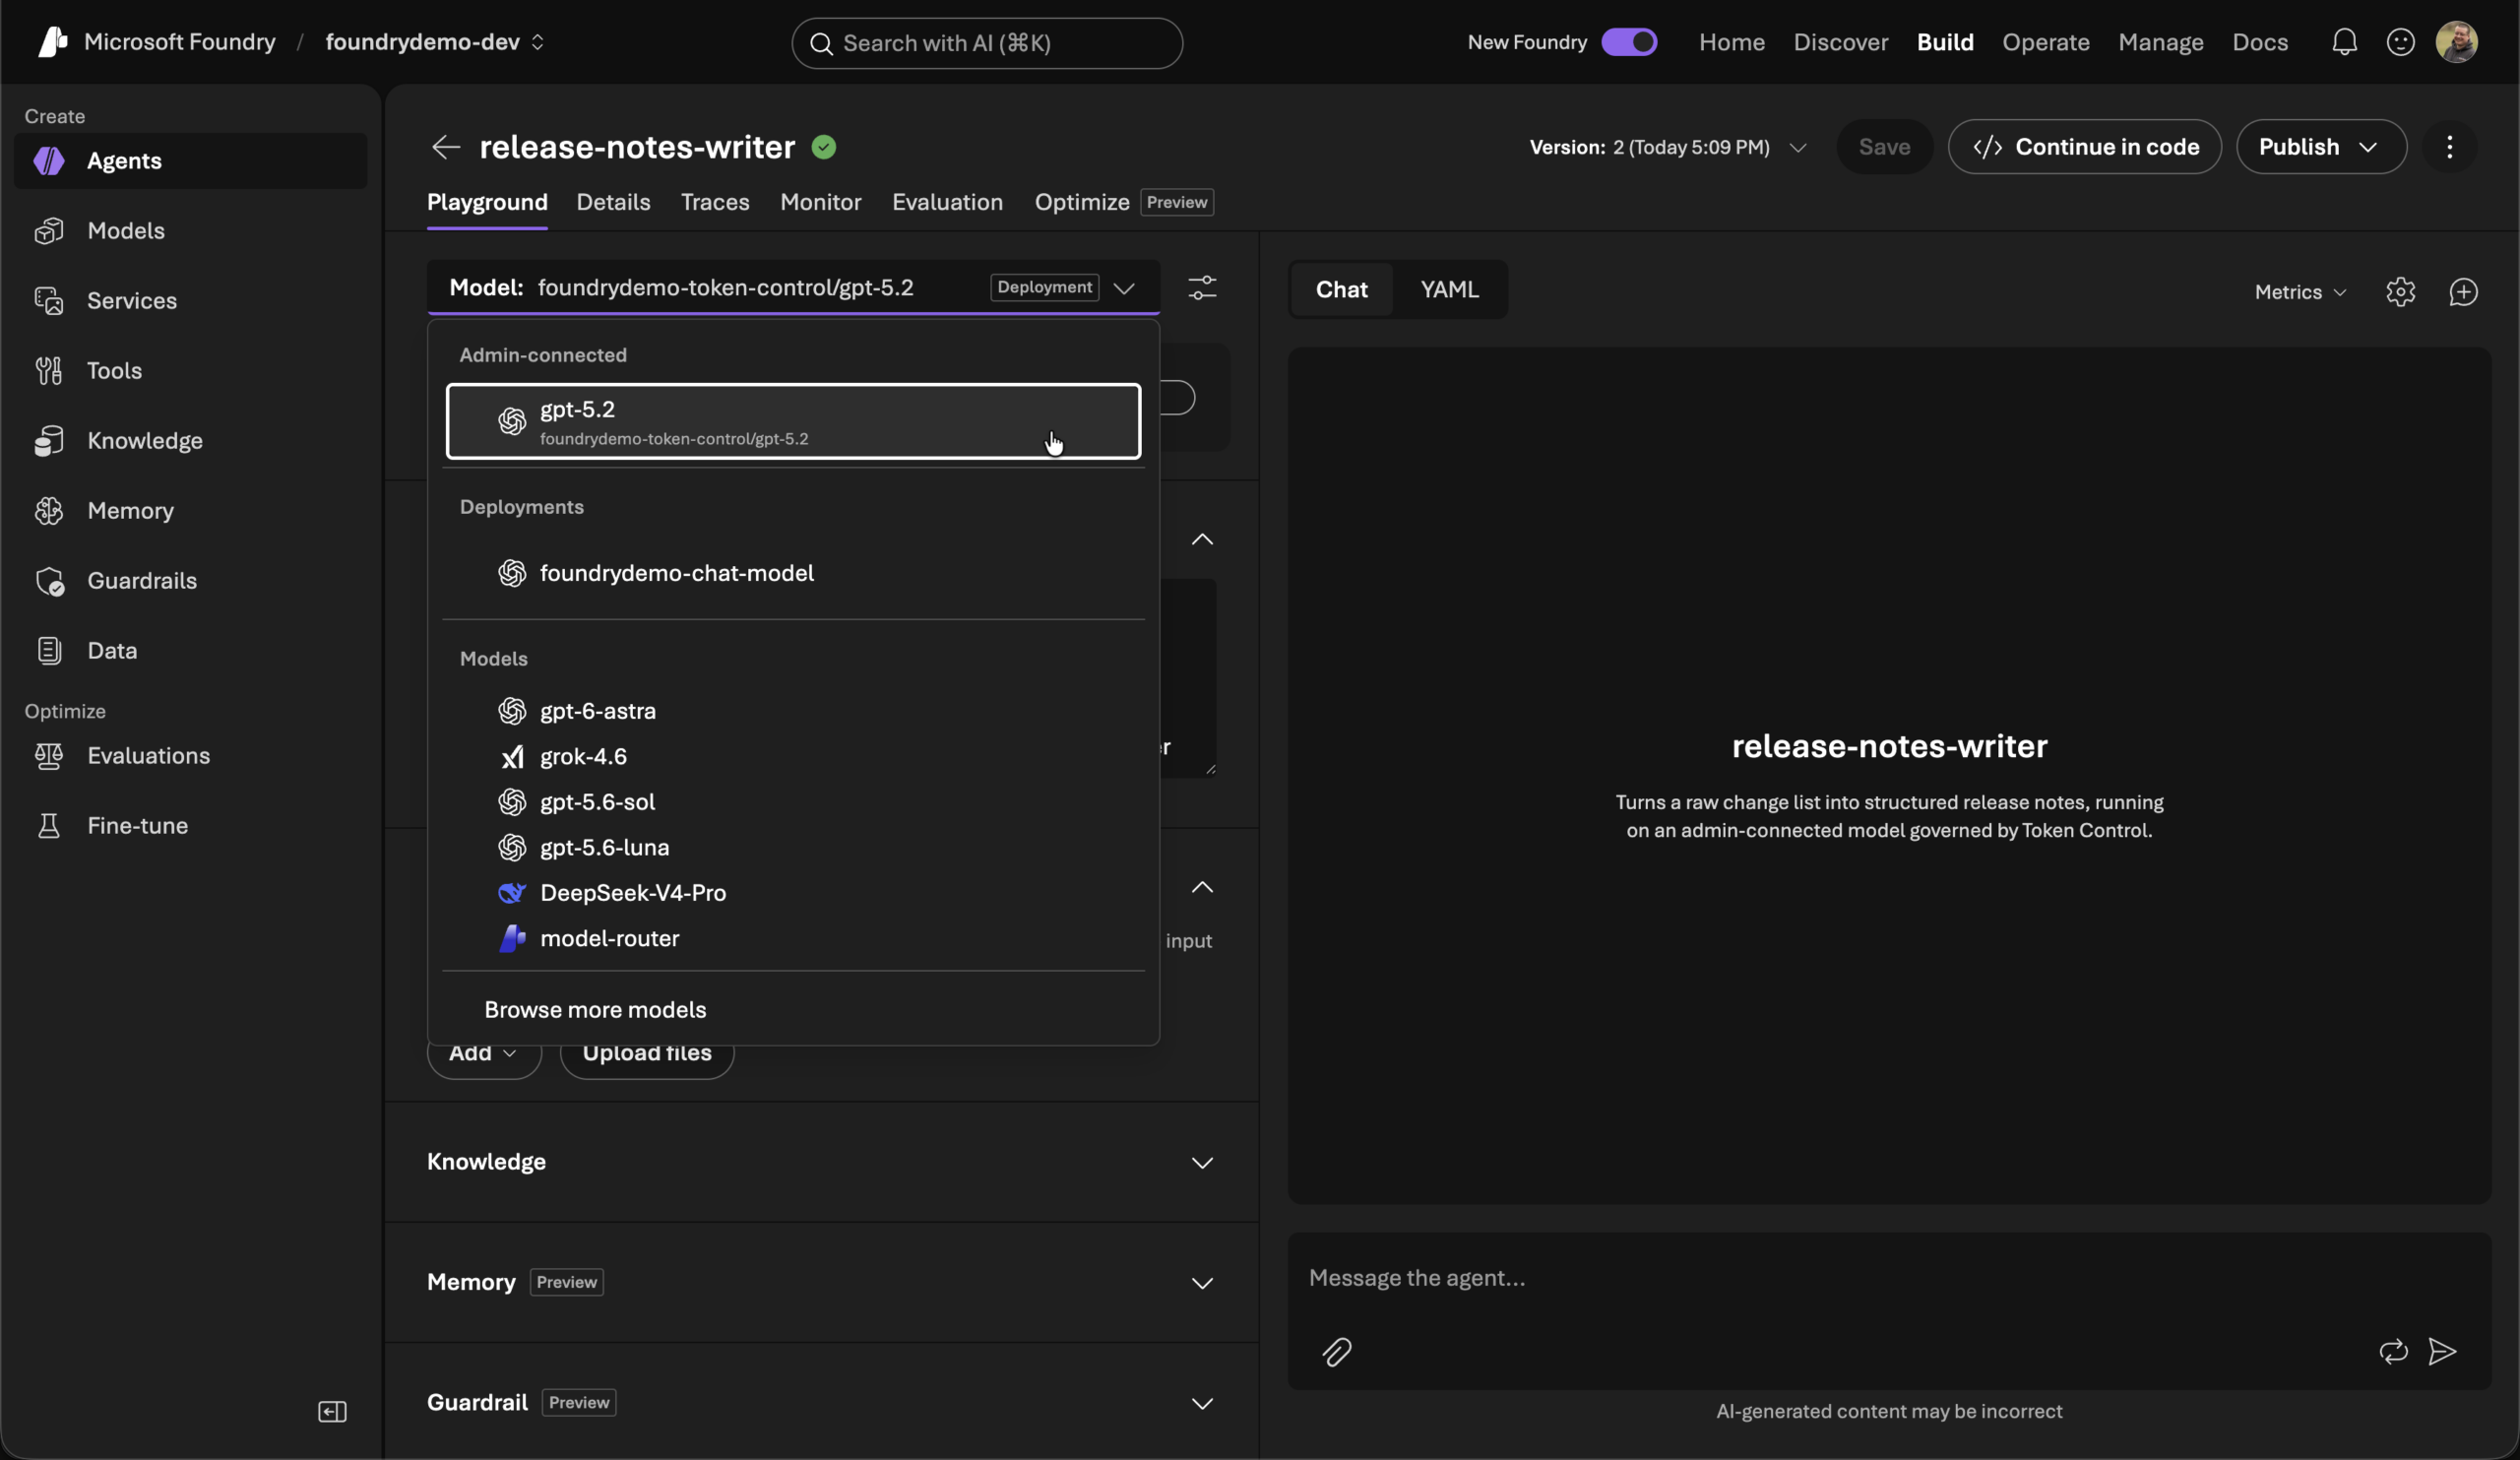
Mehr braucht es nicht. Wer einen Agenten beschreibt, wählt ein Modell aus einer Liste. Steht in dieser Liste ein Modell hinter Token Control, gelten Budget, Limit und Nachweis ab dem ersten Aufruf, ohne dass der Autor des Agenten etwas konfiguriert oder davon wissen muss.
Kontrollebene als Code statt als Klick
Für den ersten Agenten genügt das Portal. Für mehrere Umgebungen und mehrere Teams gehören Verbindung und Agent in Code, sonst bleibt die Kontrollebene ein einmaliger Klick und wird kein überprüfbarer Zustand.
Die Connection ist eine Control-Plane-Ressource. Wir legen sie mit dem AzAPI Terraform Provider an, der ARM-Ressourcen direkt anspricht:
resource "azapi_resource" "token_control" {
  type      = "Microsoft.CognitiveServices/accounts/projects/connections@2025-04-01-preview"
  name      = local.names.token_control_connection
  parent_id = azurerm_cognitive_account_project.main.id

  body = {
    properties = {
      category      = "ModelGateway"
      target        = var.token_control.base_url
      authType      = "ApiKey"
      isSharedToAll = false
      metadata = {
        deploymentInPath = "false"
        models = jsonencode([{
          name = var.token_control.deployment_name
          properties = {
            model = {
              name    = var.token_control.model_name
              version = var.token_control.model_version
              format  = "OpenAI"
            }
          }
        }])
      }
    }
  }

  sensitive_body = {
    properties = {
      credentials = { key = var.token_control_api_key }
    }
  }
}
Zwei Angaben sind dabei wesentlich. isSharedToAll = false begrenzt die Verbindung auf ein Projekt statt auf alle Projekte des Accounts und hält die Kontrollebene damit pro Umgebung trennbar. Der API-Key von Token Control gelangt ausschließlich über eine Umgebungsvariable in das sensitive_body und nie in eine tfvars-Datei.
Aus derselben Ressource folgt die Rollentrennung. Das Anlegen erfordert laut Microsoft Foundry User oder höher auf dem Projekt und Contributor auf der Resource Group. Die Verbindung liegt damit bei der Administration, die Agenten bleiben bei den Fachteams. Genau diese Trennung suchen Plattformteams, wenn sie Governance einführen wollen, ohne selbst zum Nadelöhr zu werden.
Auf der anderen Seite steht der Agent. Im Foundry SDK bleibt er eine gewöhnliche Definition, und die Modellreferenz ist die einzige Stelle, die den Unterschied ausmacht:
RELEASE_NOTES_WRITER_SPEC = PromptAgentSpec(
    name="release-notes-writer",
    description=(
        "Turns a raw change list into structured release notes, running on an "
        "admin-connected model governed by Token Control."
    ),
    instructions=RELEASE_NOTES_WRITER_INSTRUCTIONS,
    smoke_prompt=RELEASE_NOTES_WRITER_SMOKE_PROMPT,
    validate_smoke=validate_smoke,
    connected_model_env_var="FOUNDRY_CONNECTED_MODEL_DEPLOYMENT_NAME",
)
Die deklarierte Variable hat Vorrang vor dem regulären Deployment-Namen. Derselbe Agent läuft mit einer anderen Variable auf einem anderen Modell, ohne dass Instructions oder Logik sich ändern.
export FOUNDRY_CONNECTED_MODEL_DEPLOYMENT_NAME="$(
  terraform -chdir=infra output -raw connected_model_deployment_name
)"
uv run deploy-agent release-notes-writer
Terraform besitzt damit die Verbindung, das SDK besitzt die Agenten-Definition. Kontrollebene und Agent sind gemeinsam versioniert und über alle Umgebungen hinweg identisch.
Hosted Agents und eigene Agents
Für selbst entwickelte Agenten gilt dieselbe Kontrollebene, angeschlossen über die Konfiguration des Agenten.
Hosted Agents sind Container, die Foundry für Sie betreibt. Sie greifen nicht auf die Connection aus dem vorigen Abschnitt zu, sondern erhalten Endpunkt und Schlüssel über ihre eigene Konfiguration. Die Base URL ist eine gewöhnliche Umgebungsvariable, der API-Key gehört in eine Foundry-Projekt-Connection und wird über einen Platzhalter zur Laufzeit aufgelöst:
services:
  release-notes-writer:
    host: azure.ai.agent
    env:
      OPENAI_BASE_URL: https://<ihr-token-control-host>/api/v1/openai
      OPENAI_API_KEY: ${{connections.token-control.credentials.key}}
Der Schlüssel liegt damit weder im Container-Image noch im Repository. Ergänzend injiziert Foundry zur Laufzeit unter anderem FOUNDRY_PROJECT_ENDPOINT, FOUNDRY_AGENT_NAME und die Verbindung zu Application Insights, sodass Ihr Code die eigene Identität und das Ziel für Telemetrie kennt, ohne sie selbst zu verwalten.
Dasselbe Muster gilt für Azure Container Apps, Azure Kubernetes Service, Azure Functions und die lokale Entwicklungsumgebung, dort mit einem eingeschränkten API-Key je Arbeitsplatz.
Was Sie damit steuern
An dieser Stelle laufen beide Wege zusammen. Der deklarativ beschriebene Prompt Agent und der selbst entwickelte Agent erreichen dieselbe Kontrollebene, und ab dort gelten für sie dieselben Regeln, verwaltet von denselben Personen.
Budgets, die vor dem Aufruf greifen. Sie hinterlegen Budgets und Limits in Euro pro Entität, also pro Nutzergruppe, Abteilung, Kostenstelle oder KI-Lösung. Anfragen werden blockiert, bevor ein Limit überschritten wird. Ein Rate-Limit auf Tokens pro Minute schützt die Performance einer Plattform, ein Euro-Budget schützt das Budget einer Abteilung.
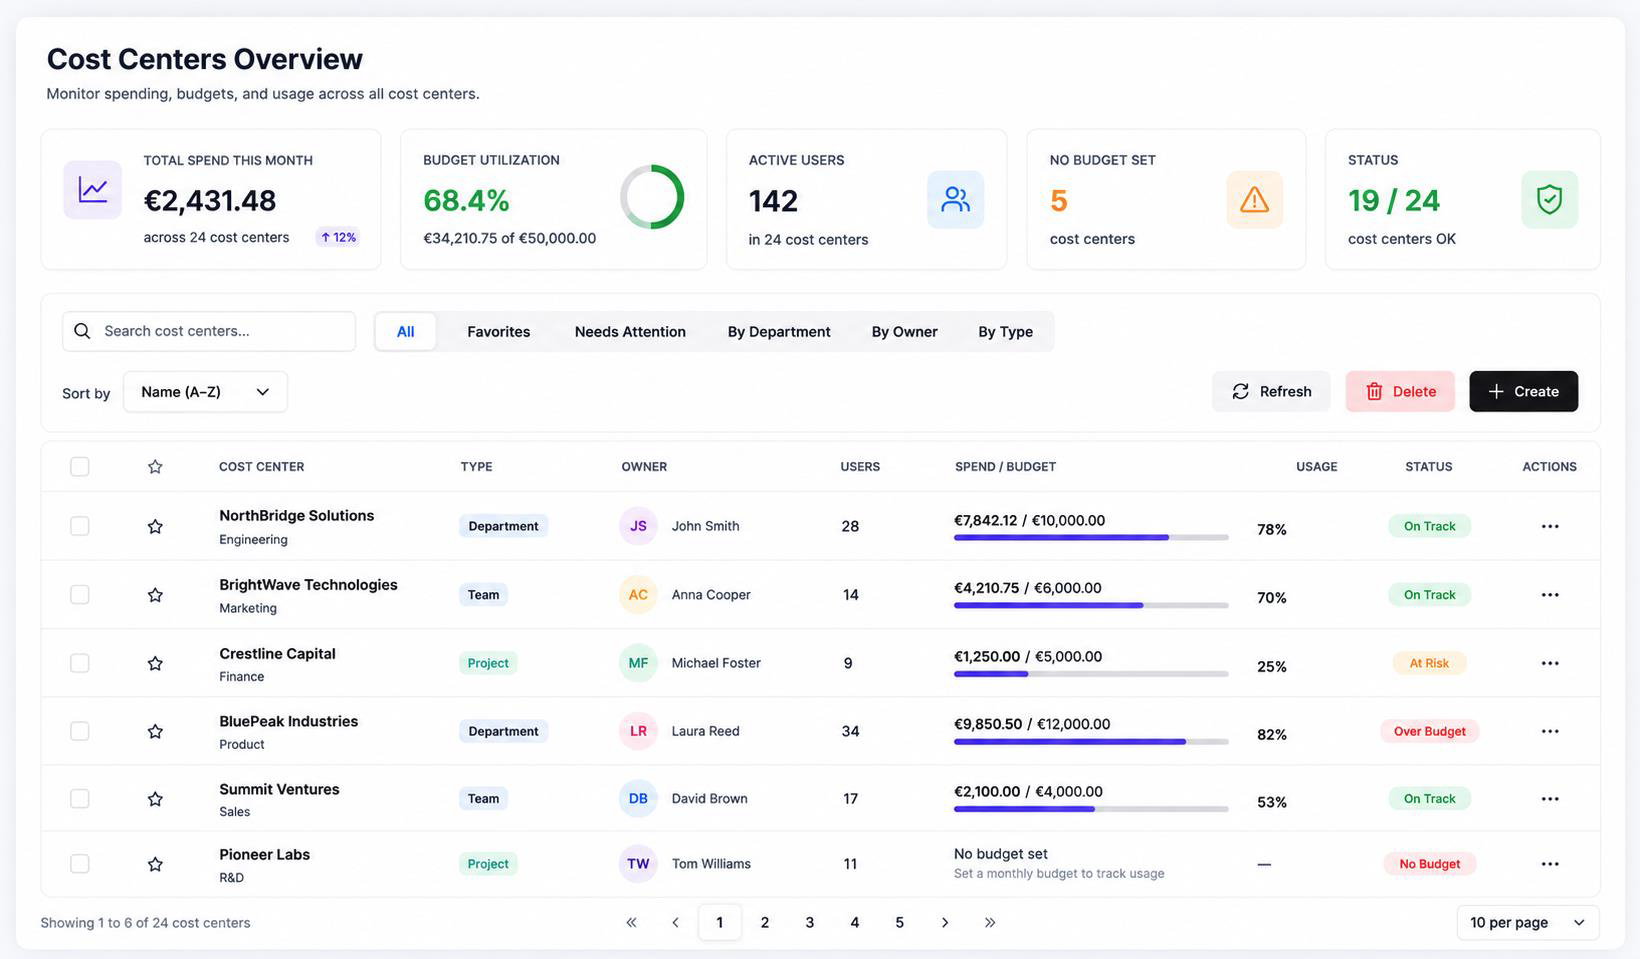
Zugriff, der einer Lösung zugeordnet ist. Jede Lösung, jedes Projekt und jedes Team erhält einen eigenen, eingeschränkten API-Key, dessen Nutzung und Kosten getrennt nachverfolgt werden. Ein rotierter oder gesperrter Schlüssel betrifft damit genau eine Lösung und nicht die gesamte KI-Nutzung. Ein TPM-Limit pro Anwendung stellt zusätzlich sicher, dass keine Anwendung die Kapazität dominiert, und der Zugriff bleibt auf die von Ihnen freigegebenen Modelle beschränkt.
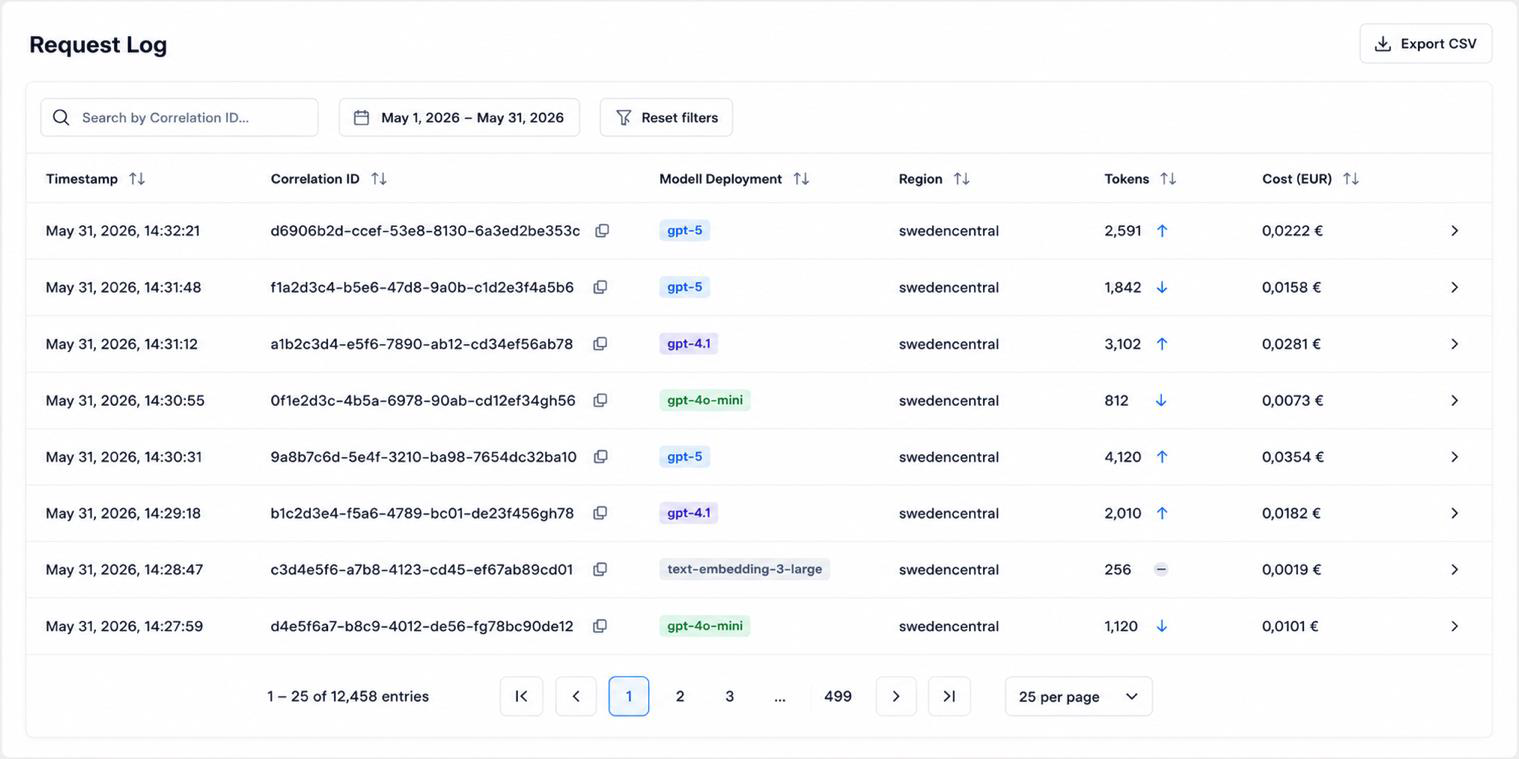
Nachweise, die einer Prüfung standhalten. Jede Anfrage wird über eine Correlation-ID protokolliert, mit Tokens, Modell, Region, Zeitstempel und Kosten.
Prompt- und Antwortinhalte werden dabei nicht gespeichert, Verarbeitung und Speicherung finden in der EU statt. Das Compliance-Dashboard zeigt zusätzlich die regionale Verteilung der genutzten Modelle und den Status der Content-Filter. Damit entsteht eine prüffähige Grundlage, die die Transparenzanforderungen des EU AI Act unterstützt, ohne dass Sie Gesprächsinhalte Ihrer Nutzer archivieren.
Die Sicht aus Foundry bleibt dabei vollständig erhalten. Läufe, Schritte, Latenz und Fehler sind weiter über Traces und den Monitor-Tab sichtbar, angebunden an Ihre Application-Insights-Ressource.
Ihr nächster Schritt
Die Kontrollebene wird einmal eingerichtet. Danach stehen alle Agenten Ihres Projekts unter denselben Regeln, unabhängig davon, wo sie laufen und ob sie deklarativ beschrieben oder selbst entwickelt sind.
In einer 30-minütigen Demo zeigen wir Token Control an Ihrem Szenario und beantworten die Fragen, die für Ihre Organisation zählen. Alle Funktionen im Detail stehen auf der Produktseite.